Forse peccano di hybris, o forse hanno ragione loro. Comunque, abbandonare git il software di versionamento costruito da Linus Torvalds per passare al proprio sistema è un segno dei tempi. Anthropic si reputa unica, eletta e fa previsioni su un mondo che sta contribuendo a inventare. La scrittura di codice, fatto dagli agenti, che procede a velocità 10x rispetto a quello fatto a mano. E richiede un approccio nuovo al versionamento. Git, il capolavoro di Linus Torvalds, è superato? Secondo loro sì.
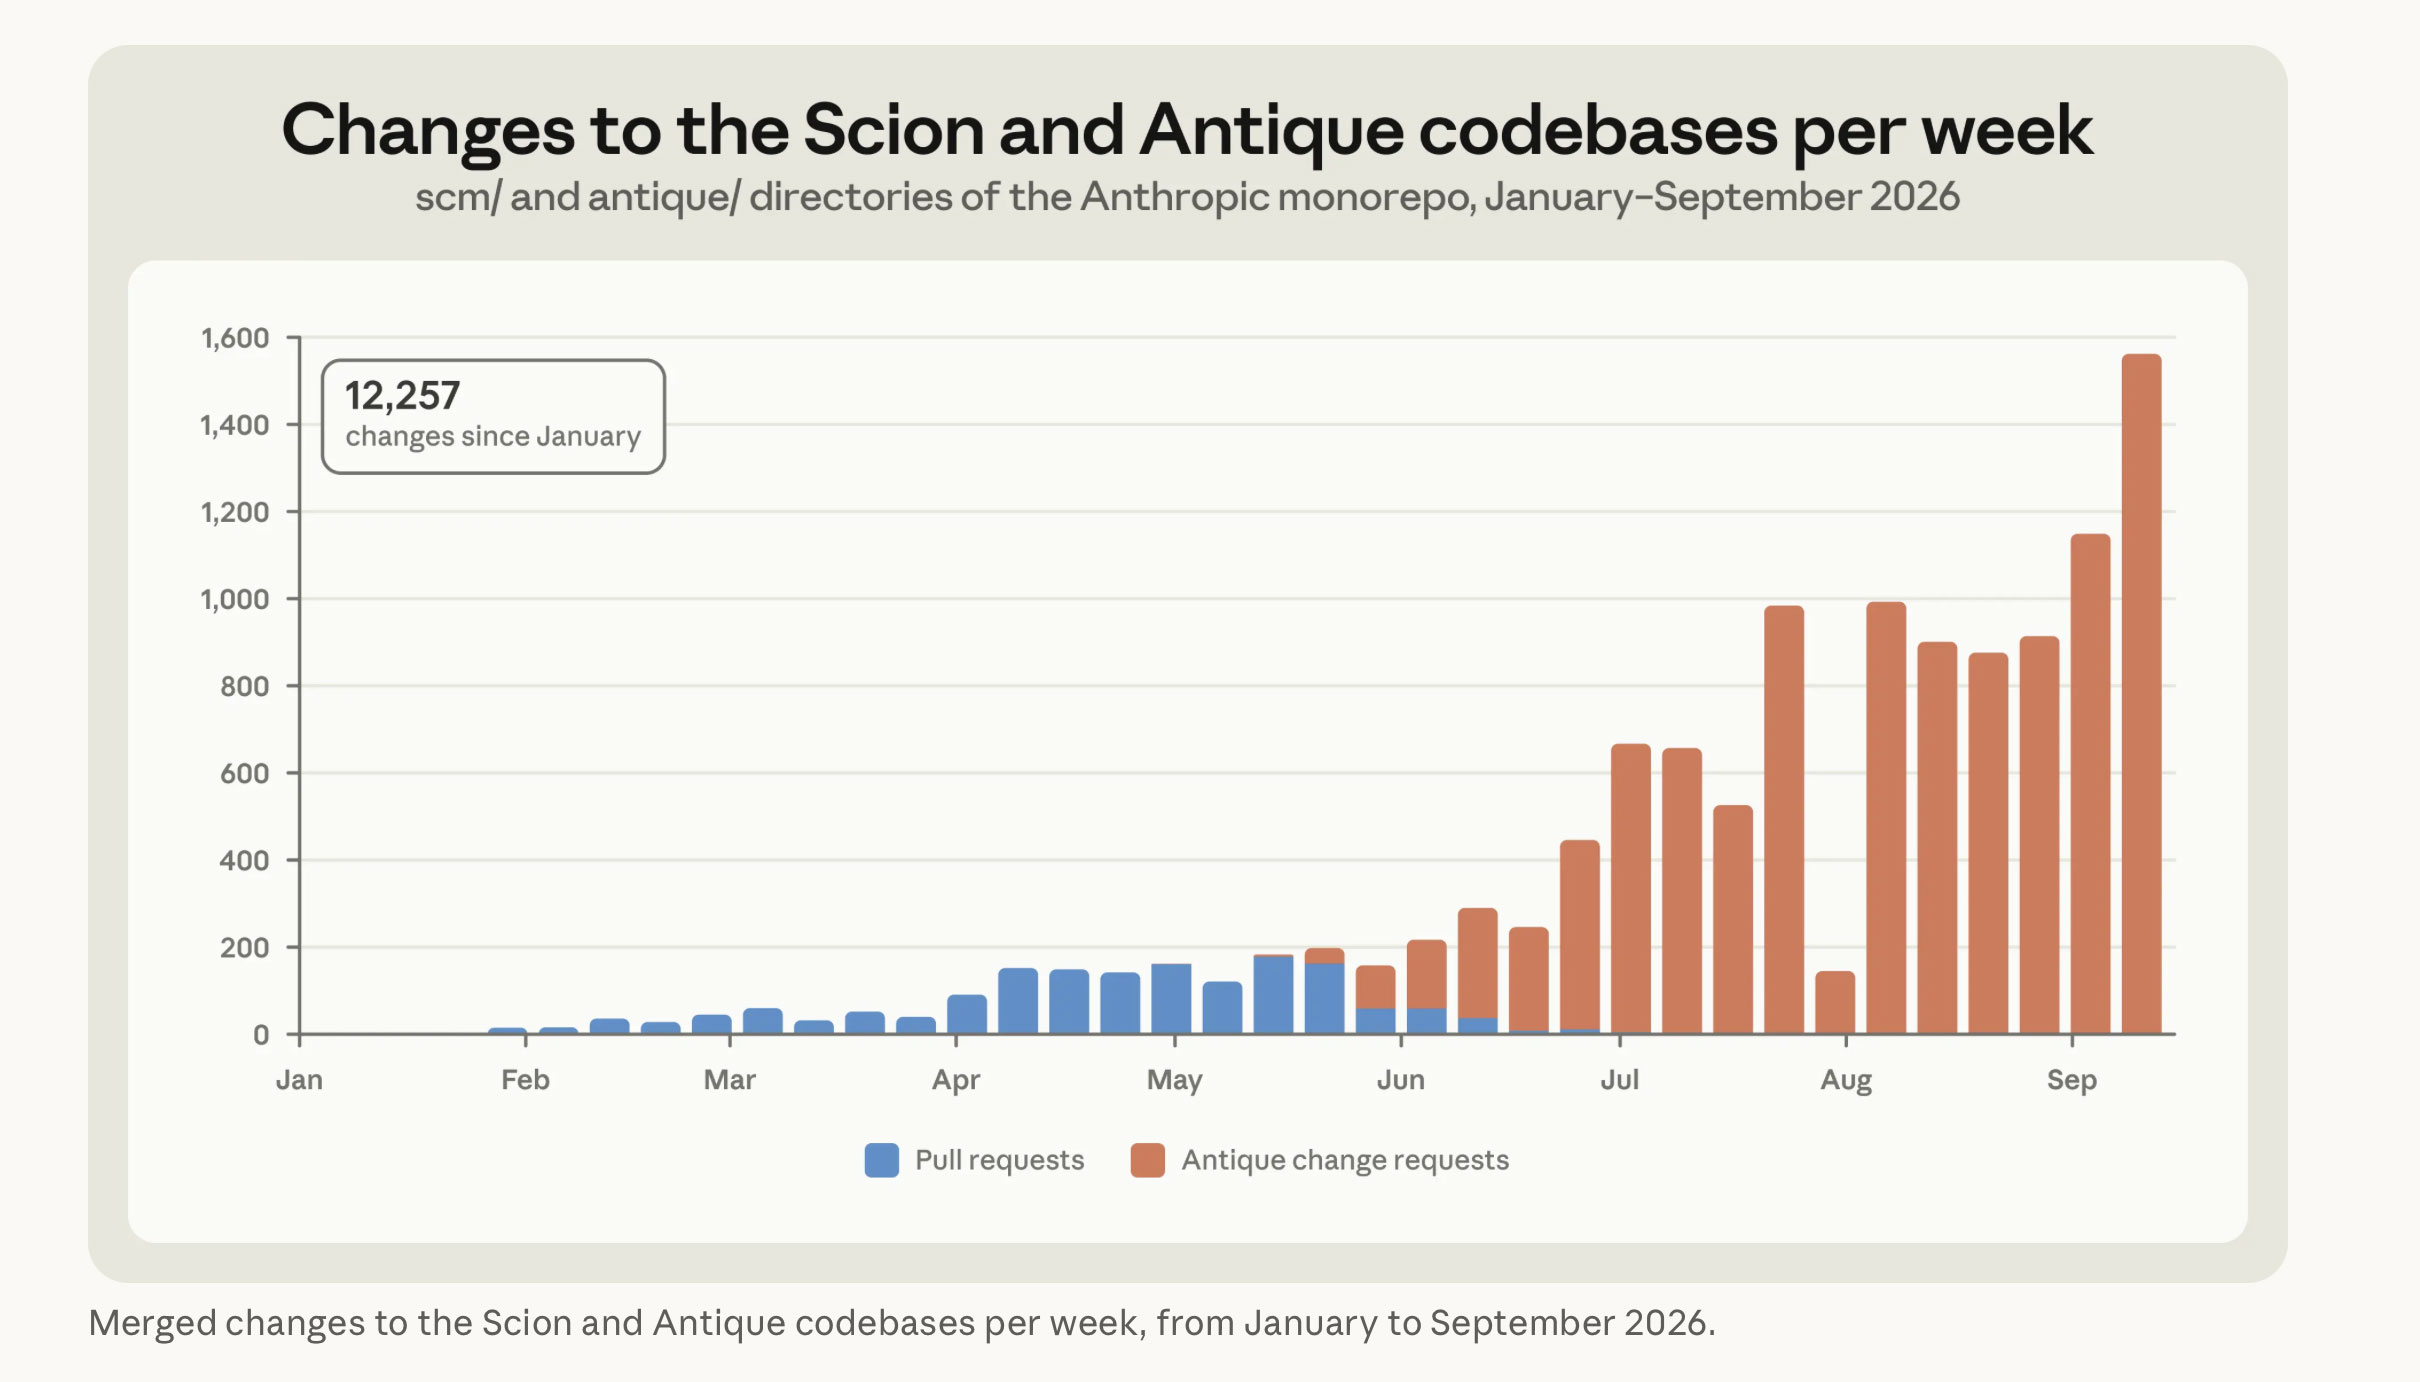
Git nasce nell’aprile 2005, scritto da Linus Torvalds per gestire lo sviluppo del kernel Linux, con un’idea che per vent’anni è sembrata imbattibile: ogni copia del progetto è completa, porta con sé tutta la storia e funziona anche senza rete. Il 13 ottobre 2026 Anthropic ha pubblicato sul proprio blog di ingegneria il racconto di come ha rinunciato a quel principio. A maggio l’azienda integrava in media circa 2500 modifiche al codice al giorno, a settembre ne integrava oltre 30mila.
Il numero, da solo, non dice molto. Conta di più il ragionamento che sta dietro: secondo Anthropic scrivere codice non è più il collo di bottiglia, perché Claude itera da solo sui cicli di ricerca, ottimizza programmi complessi e costruisce servizi da zero a una velocità mai vista. Invece, a rallentare è tutto ciò che sta intorno, cioè un’infrastruttura pensata per la scala umana: controllo del codice sorgente, build e integrazione continua (CI/CD). L’azienda, che nel frattempo ha portato Claude anche nella ricerca farmaceutica con Claude Science, definisce la domanda di integrazione del codice «praticamente infinita» e non si aspetta rallentamenti.
Il peso della storia
Un monorepo è un unico deposito che contiene il codice di un’intera azienda. Quello di Anthropic ha raggiunto dimensioni che il progetto di Torvalds non poteva neanche immaginare. La sola cronologia del ramo principale pesa quasi 100 gigabyte, una copia di lavoro compressa supera i 25 gigabyte, e ogni giorno partono circa 25 milioni di checkout, cioè prelievi del codice, solo per l’integrazione continua, senza contare gli ambienti degli sviluppatori, le sandbox degli agenti e i job di ricerca. Presi in modo ingenuo, cioè senza un po’ di furbizia, farebbero oltre 600 petabyte di traffico Git al giorno.
Gli strumenti per lavorare su una porzione del repository esistono (cloni superficiali, checkout parziali) e Anthropic li ha usati tutti. Al momento di maggiore pressione gestiva diverse centinaia di mirror Git interni, copie di appoggio che alleggerivano il server principale. Bastava finché il ritmo restava basso. Con l’aumento delle integrazioni gli snapshot si allontanano dal vertice del ramo principale, e le operazioni che dipendono dalla storia, per esempio sapere chi ha modificato una certa riga, diventavano sempre più delicate e fragili sulle copie parziali.
Sempre connessi
A quel punto gli ingegneri hanno notato che git veniva usato come un sistema centralizzato, con una copia autorevole, mentre quasi tutti i suoi clienti erano agenti e job automatici, online per definizione. Le proprietà che rendono git ideale per il lavoro distribuito e offline lavoravano contro la scalabilità. Da qui il punto di partenza del progetto: disegnare un controllo di versione sapendo fin dall’inizio che gli agenti non si disconnettono mai.
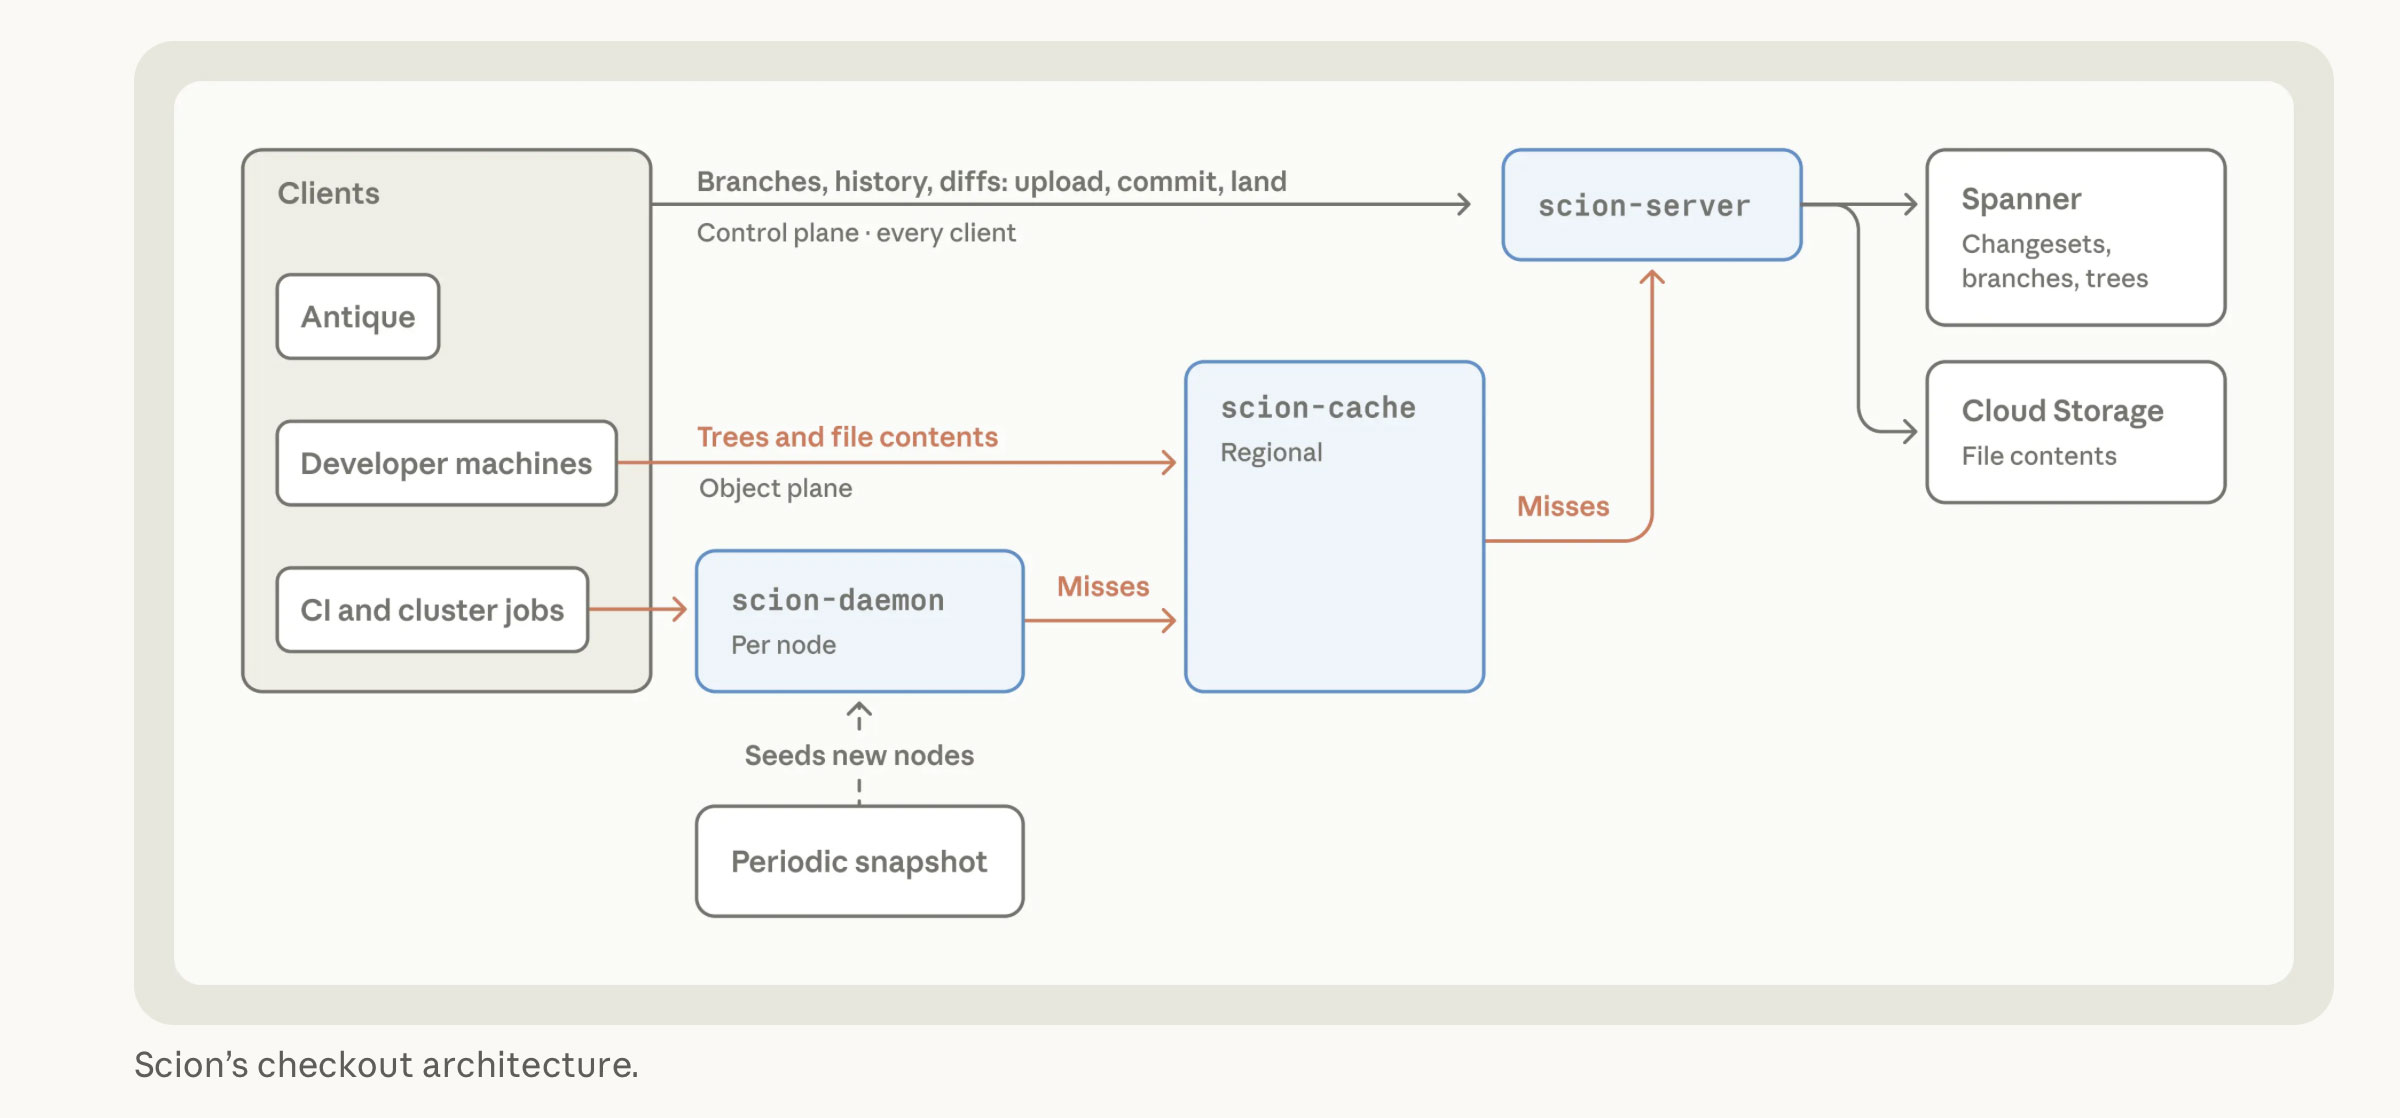
Per i monorepo giganti esistono precedenti, Piper di Google e Sapling di Meta, e Anthropic dichiara di aver tenuto presenti le loro lezioni. Scion rovescia comunque l’asimmetria di git. Nel sistema di Torvalds ogni client può fare da server. In Scion il server risponde alle domande sulla storia dei file, crea i commit, esegue merge e rebase, mentre il client mantiene una piccola cache locale di oggetti, dispone i file sul disco e controlla le modifiche al file system. Calcola poco, in cambio ha bisogno di pochissimi dati. Ogni commit nasce direttamente sul server, quindi non c’è nessun passaggio di push, e i rami sono scoraggiati, tranne quello principale e quelli di rilascio, perché uno stato globale su cui ogni server deve essere d’accordo è un problema di scala in agguato.
Il server fa tutto
Tutte le interrogazioni che il client usa sono esposte anche come interfacce di programmazione. Un job che vuole sapere chi ha toccato per ultimo una riga, o come sono imparentati due commit, lo chiede al server senza tenersi una copia locale del repository. Le pipeline interne di bisect e revert automatici, scrive l’azienda, non sarebbero praticabili su questa scala senza un accesso così economico alle informazioni.
Sul fronte dei file il protocollo ruota intorno ai checkout parziali e virtualizzati, in cui i file arrivano sul disco solo quando qualcuno li legge davvero. Il client non racconta al server che cosa possiede già: parte da una radice e chiede, in modo ricorsivo, gli oggetti che mancano. Ogni richiesta riguarda un oggetto che non cambia mai, quindi qualunque cache può rispondere, e l’architettura somiglia a una gerarchia di cache classica, con un demone su ogni nodo, cache regionali e server autorevoli che leggono dal database Spanner o dallo storage. Ogni livello ha un tasso di successo della cache superiore al 99 per cento. L’infrastruttura di Scion occupa 200 volte meno processore e memoria della vecchia flotta di mirror, i checkout richiedono secondi invece di minuti, e la sola integrazione continua ha liberato il 25 per cento della propria capacità di calcolo.
Sette persone e un modello
A costruire Scion, lo strumento di revisione del codice Antique e una mezza dozzina di sistemi collegati è stato un gruppo di sette persone, in cinque mesi, mentre il volume dei merge cresceva di dieci volte rispetto alla partenza. In passato un’operazione simile avrebbe richiesto anni e molti più ingegneri. Il caso non è isolato: in questi giorni un singolo sviluppatore ha realizzato, con l’aiuto di Claude Opus 5.5, una famiglia di alternative gratuite ai programmi Adobe. È un modo diverso di scrivere codice: non dilettanti allo sbaraglio, ma esperti capaci di pilotare macchinari logici estremamente complessi.
L’episodio più citato dal post riguarda la pipeline che trasferisce i dati da git a Scion. La prima versione, un prototipo, era stata scritta in gran parte a mano. Quando in azienda è arrivata un’istantanea interna preliminare di Claude Mythos Preview, le è stato chiesto di riscriverla da capo, senza altre istruzioni. La nuova versione consumava 20 volte meno memoria, girava quattro volte più veloce e conservava le regole implicite sull’ordine di ingestione dei dati.
Dire di no a Claude
Tutti gli ingegneri del gruppo giudicano Claude più bravo di loro a scrivere codice. Restano loro a decidere come i sistemi si incastrano e quali compromessi accettare. «Molto spesso abbiamo scoperto che il ruolo degli ingegneri era dire a Claude di “no”», scrive Anthropic. Più sistemi, per esempio, cercavano di scoprire quando una modifica fosse entrata nel ramo principale leggendo in sequenza il registro dei commit, invece di chiederlo allo strumento di revisione. In un altro caso una revisione avversariale ha spinto Claude ad aggiungere controlli eccessivi verso un servizio interno già affidabile. Gli ingegneri rivedono ancora ogni richiesta di modifica, ma esaminano l’intenzione e non più ogni riga.
Il resto del ciclo di sviluppo viene rimesso in discussione. Una coda di merge classica ha poco senso quando centinaia o migliaia di modifiche entrano mentre i test girano: Anthropic non è riuscita a replicare il blocco globale del repository che lo standard del settore prevede e ha puntato sui test automatici dopo il merge e prima del rilascio. Le modifiche concorrenti possono entrare in conflitto, ma secondo l’azienda Claude di solito risolve i conflitti più in fretta di quanto gli umani riescano a individuarli. Per sorvegliare i componenti, nei canali Slack lavorano dei “superfan”, istanze di Claude Tag incaricate di tenere d’occhio un solo pezzo del sistema ciascuna: una la cache, un’altra la coda di merge di Antique, con accesso a telemetria e log.
Niente open source
Scion non verrà rilasciato. Anthropic lo definisce «in nessun caso un sostituto adatto» di git per l’uso generale: ha senso solo per monorepo enormi, con decine di migliaia di ingegneri o sciami di agenti, richiede una propria revisione del codice, una propria ricerca e una propria integrazione continua, e si regge su un budget di token interno che nessun’altra azienda spenderebbe. Verranno pubblicate le idee. L’azienda prevede che problemi simili diventino comuni altrove tra sei e dodici mesi e spera di collaborare con GitHub, GitLab e la comunità open source per portare i principi di Scion dentro git, a cominciare da un server che non debba funzionare come il client e da chiamate lato server standardizzate tra le diverse piattaforme.
Nel post compare anche un riconoscimento: la comunità git ha passato quasi vent’anni a far scalare la piattaforma per milioni di sviluppatori, e il contributo di Anthropic, ammette l’azienda, è molto più ristretto. Per i milioni di checkout quotidiani di Anthropic la rete c’è sempre. Invece, il portatile senza connessione, per ora, resta una faccenda umana.
Tutte le notizie che parlano di Intelligenza Artificiale sono disponibili a partire da questa pagina di Macitynet.1