

Apple ha sviluppato Minions, un sistema che permette di sfruttare le GPU inutilizzate dei Mac con chip Apple Silicon, trasformando computer già presenti in ufficio in una riserva condivisa di potenza di calcolo per l’intelligenza artificiale.
L’obiettivo è consentire ai gruppi di sviluppo di eseguire operazioni di IA senza dover aspettare che si liberino i server GPU aziendali o acquistare nuove macchine. Il sistema, già sperimentato internamente da Apple, è per ora un progetto di ricerca e non una funzione disponibile direttamente in macOS.
Come Minions mette al lavoro i Mac inutilizzati
Durante una normale giornata lavorativa, le GPU di molti Mac rimangono inutilizzate per buona parte del tempo. Minions permette di impiegarle per eseguire operazioni di inferenza, cioè elaborazioni effettuate da modelli di intelligenza artificiale già addestrati.
Per esempio, un gruppo di Mac può collaborare nell’analisi di grandi raccolte di documenti, nella generazione di rappresentazioni vettoriali utilizzate dai motori di ricerca o nell’elaborazione di richieste destinate ai modelli linguistici.
Il funzionamento è diverso da quello dei cluster di Mac collegati tramite Thunderbolt 5 e RDMA. Minions non richiede collegamenti diretti tra i computer e non unisce la loro memoria. Ogni Mac esegue autonomamente una parte del lavoro, utilizzando la propria GPU e comunicando con i servizi centrali attraverso la rete.
Come vengono distribuiti i compiti
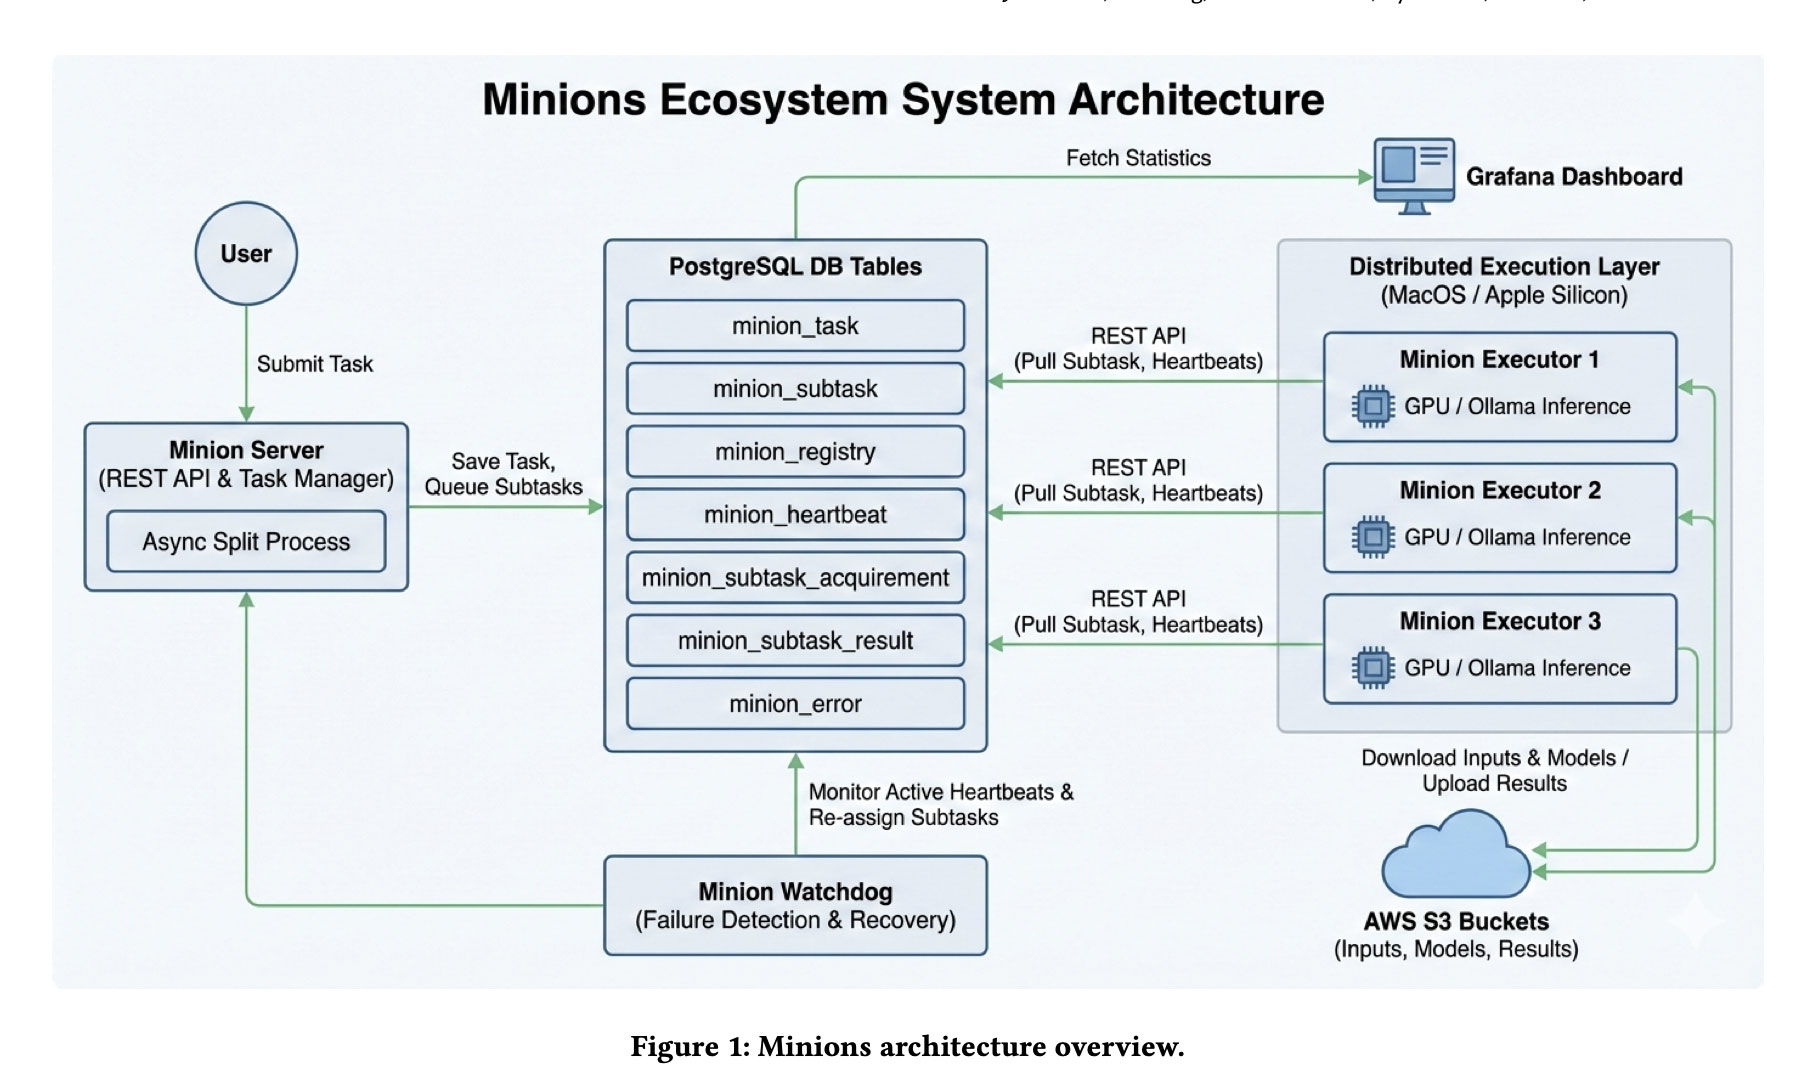
L’architettura prevede un Minion Server che riceve le richieste, le suddivide in operazioni più piccole e le registra in un database PostgreSQL.
Su ogni Mac partecipante viene eseguito un programma chiamato Minion Executor, che recupera i compiti disponibili attraverso API REST e li elabora utilizzando la GPU locale. Per i modelli linguistici il sistema supporta Ollama, di cui abbiamo spiegato il funzionamento su Mac, mentre per altre operazioni utilizza modelli disponibili su Hugging Face.
I dati necessari e i risultati vengono gestiti attraverso uno spazio di archiviazione condiviso, nell’implementazione descritta da Apple basato su Amazon S3.
Se un Mac viene spento, perde la connessione o torna a essere utilizzato dal proprietario, il Minion Watchdog rimette in coda le operazioni incomplete, che possono essere riprese da un’altra macchina. Una dashboard permette di controllare l’attività del sistema.
Da oltre 10 ore di attesa a pochi minuti
Nel documento tecnico pubblicato dai ricercatori Apple emerge un risultato significativo: alcuni lavori di inferenza che prima rimanevano in attesa per oltre dieci ore, a causa della disponibilità limitata delle GPU centralizzate, con Minions possono iniziare entro pochi minuti.
Il miglioramento riguarda quindi il tempo trascorso in coda prima dell’elaborazione. La durata del calcolo dipende invece dal modello utilizzato, dal carico e dalle prestazioni dei Mac coinvolti.
Come segnalato anche da AppleInsider, il vantaggio è poter aumentare la capacità di elaborazione sfruttando computer già disponibili.
Vantaggi, consumi e limiti
Minions può ridurre la necessità di acquistare nuove GPU dedicate, ma richiede comunque un’infrastruttura software per coordinare i lavori, conservare i dati e gestire gli accessi.
L’utilizzo prolungato delle GPU comporta inoltre maggiori consumi elettrici e temperature di esercizio più elevate. La convenienza dipende quindi dal numero di Mac disponibili, dal tempo di utilizzo e dalle esigenze dell’organizzazione.
C’è anche il problema della riservatezza dei dati: Apple prevede configurazioni separate per gruppi di lavoro, con database e insiemi di Mac dedicati.
Per ora Minions rimane una soluzione destinata alla ricerca e agli ambienti professionali. Mostra però come una parte della potenza di calcolo già presente negli uffici possa essere utilizzata per alleggerire il lavoro dei server dedicati all’IA.
Per approfondire su Macitynet
Per comprendere meglio le differenze tra Minions e i cluster tradizionali abbiamo spiegato come i Mac Studio M5 Ultra possono collaborare utilizzando Thunderbolt 5, RDMA e memoria unificata.
Chi vuole invece conoscere le possibilità dei singoli computer può partire dalla nostra guida dedicata all’intelligenza artificiale locale sui Mac Apple Silicon, con un confronto tra configurazioni hardware, dimensioni dei modelli e strumenti software.