Con macOS 27 Apple rende molto più semplice collegare più Mac tramite Thunderbolt 5 per utilizzarli insieme nei carichi di Intelligenza Artificiale. La tecnologia si chiama RDMA, Remote Direct Memory Access, ed era già disponibile da macOS Tahoe 26.2, ma fino ad ora per attivarla era necessario passare dalla modalità di recupero di macOS e utilizzare il Terminale.
Con il nuovo sistema operativo la procedura cambia: sui Mac compatibili compare direttamente un controllo nelle Impostazioni di Sistema. Una modifica apparentemente piccola che rende molto più accessibile la possibilità di costruire sulla propria scrivania un cluster di Mac destinato all’AI locale.
Non significa però trasformare due o quattro Mac in un unico computer con centinaia di gigabyte o addirittura terabyte di memoria unificata. Ogni Mac conserva la propria memoria locale: sono MLX e gli altri componenti software a distribuire modello, dati e calcoli fra le diverse macchine utilizzando Thunderbolt 5 come collegamento ad alta velocità.
Con macOS 27 RDMA si attiva dalle Impostazioni
RDMA over Thunderbolt è supportato da Apple a partire da macOS 26.2 sui Mac con Apple silicon dotati di Thunderbolt 5. La funzione non è quindi tecnicamente limitata ai Mac Studio, anche se sono proprio questi ultimi, grazie alla grande quantità di memoria unificata disponibile, a rappresentare uno dei casi d’uso più interessanti per l’Intelligenza Artificiale.
Con macOS 26.2 la procedura richiedeva però diversi passaggi. Era necessario riavviare il computer in macOS Recovery, aprire Terminale, eseguire il comando rdma_ctl enable e riavviare nuovamente la macchina.
Con macOS 27 la situazione cambia. Come ha verificato il sito giapponese Macotakara, è sufficiente aprire Impostazioni di Sistema > Privacy e sicurezza > Strumenti di sviluppo, cercare RDMA e attivare RDMA over Thunderbolt. Il Mac viene quindi riavviato per completare l’operazione.
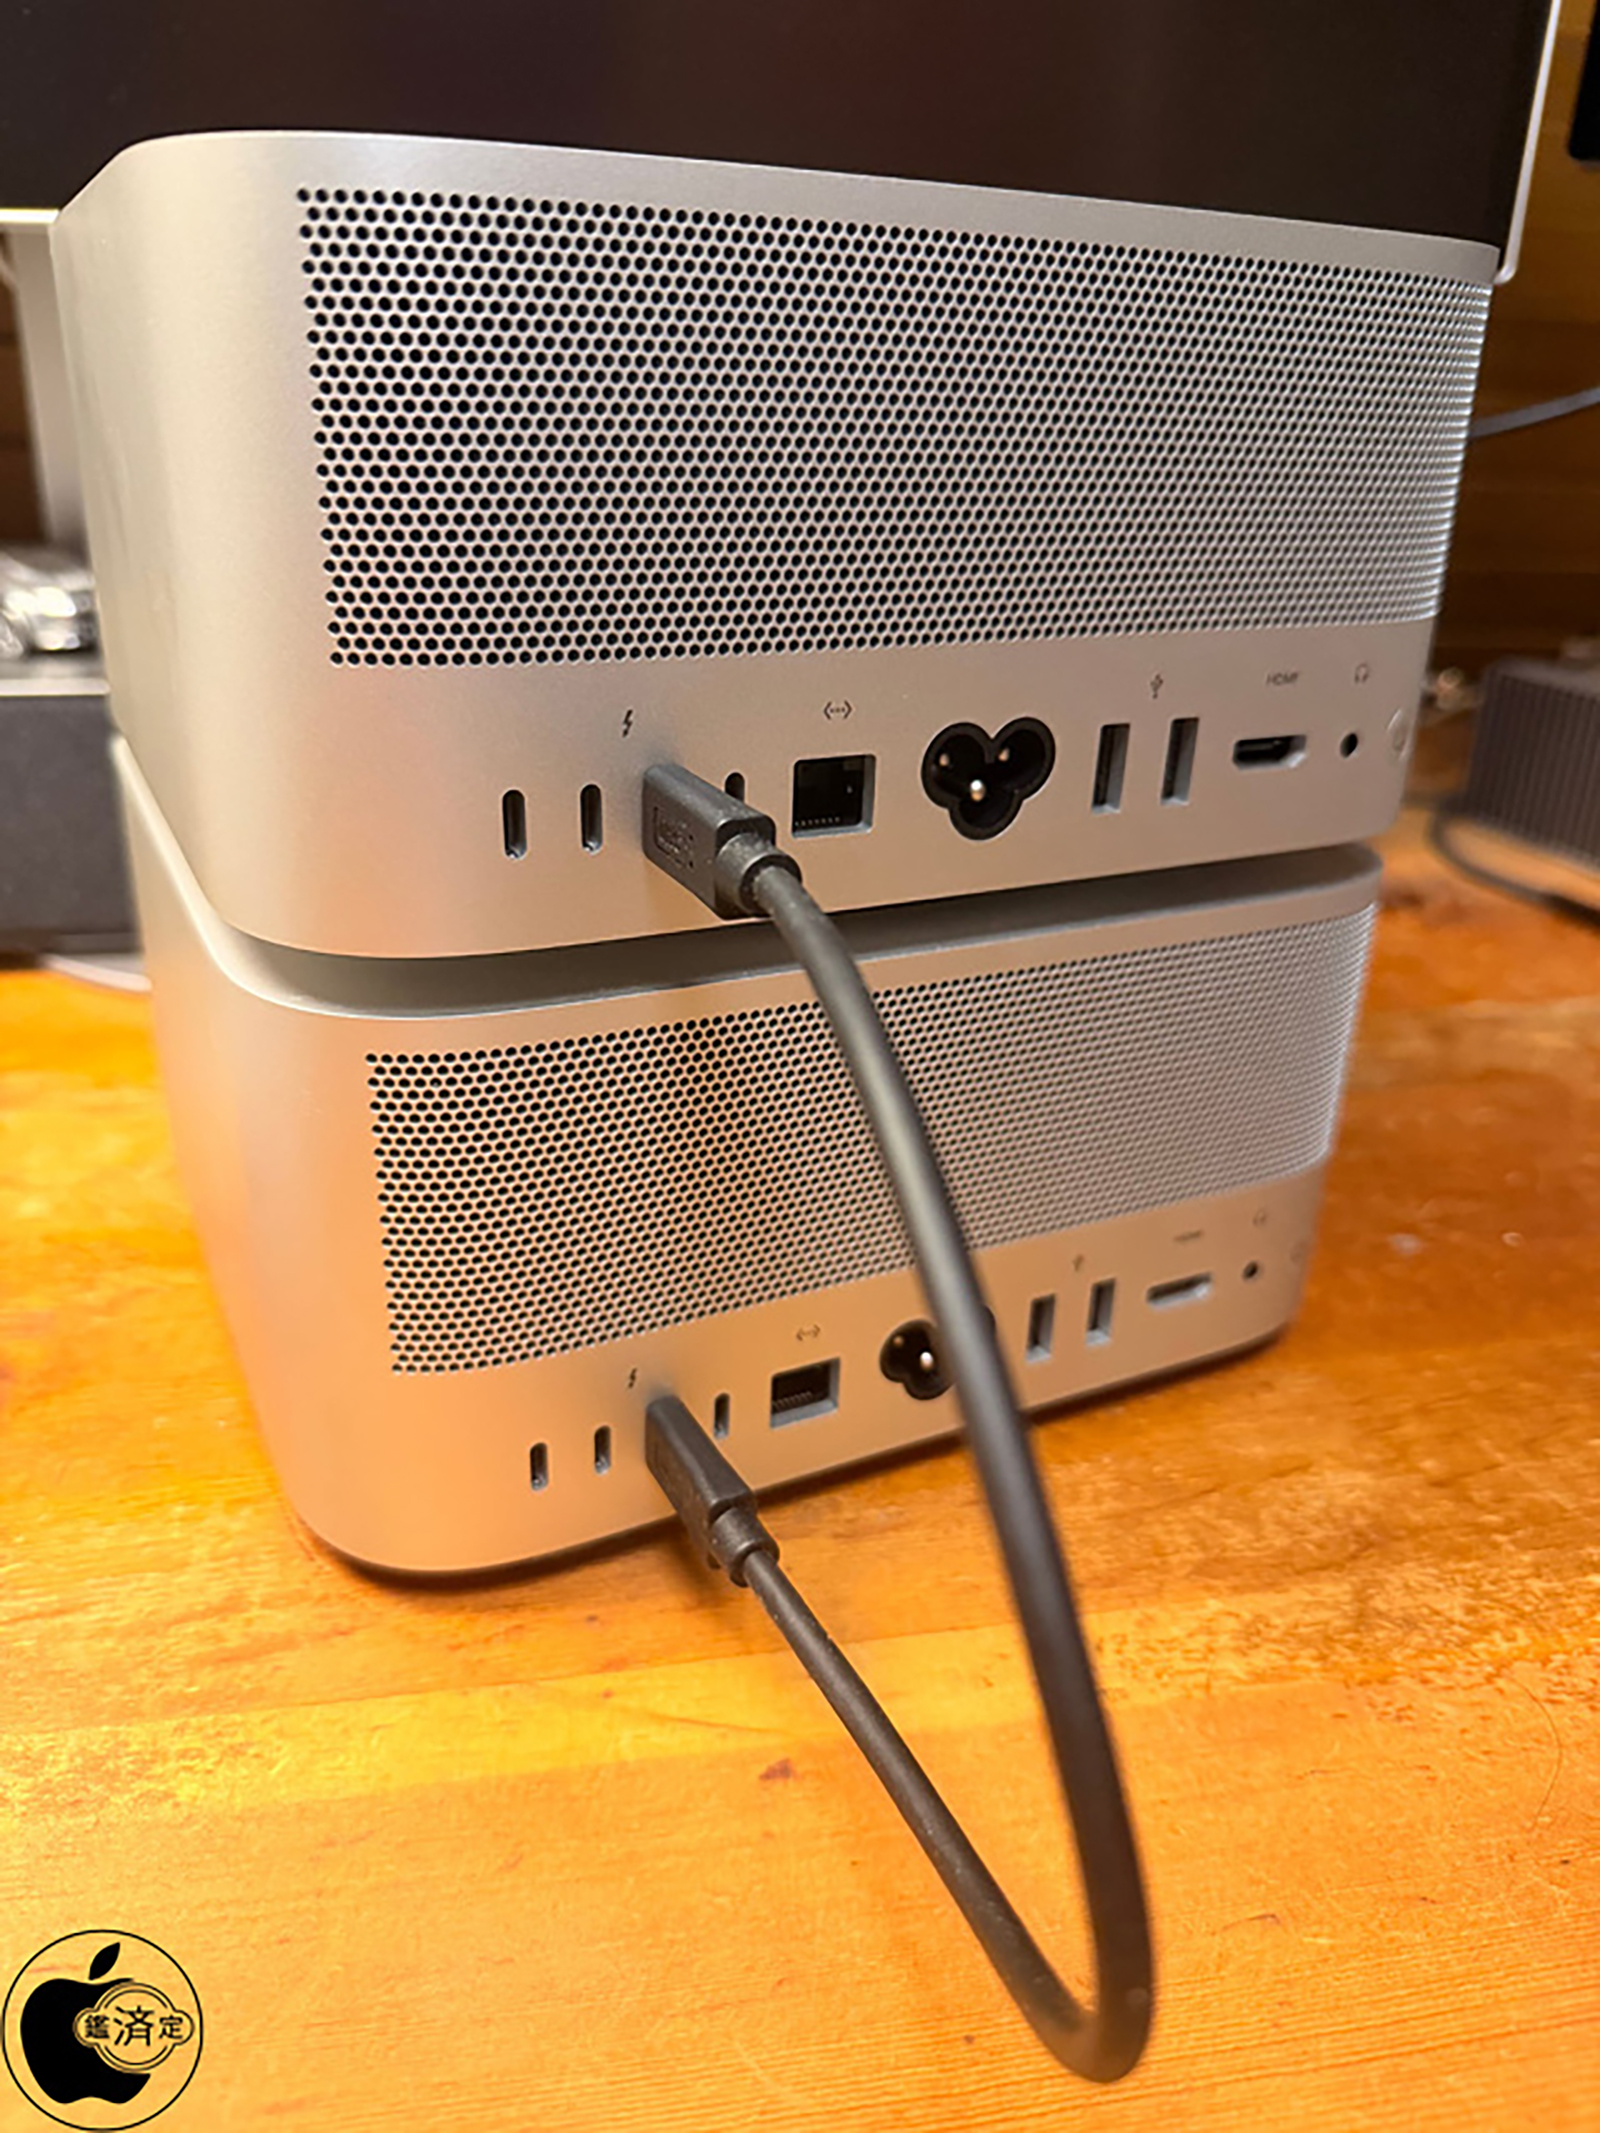
Apple affronta direttamente l’argomento anche nella sessione tecnica Explore distributed inference and training with MLX della WWDC26, dove mostra come configurare quattro Mac Studio, scegliere la topologia dei collegamenti e distribuire inferenza e fine-tuning.
RDMA non trasforma più Mac in un computer con una sola grande RAM
Questo è il passaggio più importante per capire cosa può fare realmente il sistema.
RDMA permette di trasferire dati direttamente dalla memoria di un Mac a quella di un altro, evitando buona parte del lavoro normalmente svolto dalla CPU, dal sistema operativo e dallo stack di rete.
Due Mac Studio da 256 GB dispongono quindi complessivamente di 512 GB di memoria sulla quale un’applicazione distribuita può ripartire il proprio lavoro, ma ciascun Mac continua ad avere fisicamente i propri 256 GB.
Non nasce un ipotetico Mac Studio con 512 GB di memoria unificata ai quali CPU e GPU possono accedere con la stessa latenza e la stessa banda della RAM installata localmente.
La differenza ha conseguenze pratiche. All’interno di un Mac Studio M5 Ultra la memoria unificata può raggiungere una banda di 1,2 TB/s; per comunicare con la memoria dell’altro Mac bisogna invece attraversare Thunderbolt 5.
RDMA riduce copie dei dati, latenza e intervento della CPU, ma non elimina questa differenza fisica.
È un aspetto che abbiamo approfondito anche mettendo a confronto Mac Studio M5 Ultra da 96 e 256 GB e l’alternativa costituita da due macchine: se un grande modello entra interamente nella memoria di un singolo Mac, evitare la comunicazione tra nodi conserva vantaggi evidenti in semplicità e latenza.
Da Thunderbolt all’AI: RDMA, JACCL e MLX lavorano insieme
RDMA costituisce soltanto il livello di trasporto.
Apple spiega che RDMA over Thunderbolt permette di trasferire i dati fra le memorie delle diverse macchine. Sopra questo livello interviene JACCL, la libreria open source di comunicazione collettiva sviluppata da Apple per coordinare lo scambio di dati fra più nodi.
Il livello superiore è MLX, il framework Apple per il machine learning su Apple silicon. MLX utilizza JACCL per orchestrare inferenza e addestramento distribuiti, decidendo quali parti del modello e del calcolo devono essere eseguite sulle diverse macchine.
La catena può essere letta così:
Thunderbolt 5 fornisce il collegamento fisico;
RDMA trasferisce i dati direttamente fra le memorie;
JACCL gestisce la comunicazione collettiva fra i nodi;
MLX distribuisce modello e calcolo.
È questa combinazione, e non RDMA preso isolatamente, che permette a più Mac di collaborare sullo stesso modello.
Quattro Mac Studio arrivano quasi a tre volte la velocità
Alla WWDC26 Apple ha mostrato un cluster composto da quattro Mac Studio con M3 Ultra.
Con Qwen 3.6 da 27 miliardi di parametri, MLX LM suddivide il modello fra le quattro macchine. Nel test Apple il cluster ha generato token a una velocità quasi tre volte superiore rispetto allo stesso modello eseguito su un singolo M3 Ultra.
Il numero va interpretato correttamente: quattro computer non significano automaticamente prestazioni quattro volte superiori.
Parte del tempo viene impiegata per trasferire e sincronizzare dati fra i nodi e il risultato cambia in funzione delle dimensioni e soprattutto dell’architettura del modello.
Nel fine-tuning Apple ha mostrato un secondo esempio. Con Qwen 3.5 9B un singolo M3 Ultra elaborava circa 180 token al secondo, mentre il cluster arrivava a circa 600 token al secondo, superando in questo caso il triplo delle prestazioni.
| Utilizzo | Cosa fa il cluster | Vantaggio principale |
|---|---|---|
| Modello che entra già su un Mac | Divide il calcolo fra più nodi | Può aumentare la velocità di inferenza |
| Modello troppo grande per un Mac | Distribuisce i pesi fra più memorie locali | Permette di eseguire modelli che non entrano su un singolo nodo |
| Fine-tuning | Distribuisce dati e calcolo | Riduce il tempo necessario all’elaborazione |
Pipeline e Tensor Parallelism, due modi diversi di distribuire un modello
MLX può suddividere un modello fra più computer con strategie differenti.
Con il pipeline parallelism ogni Mac conserva gruppi diversi di layer. I dati attraversano progressivamente le varie macchine e la quantità di comunicazione necessaria è relativamente contenuta.
Questa strategia è utile soprattutto quando il problema consiste nel far entrare un modello troppo grande nella memoria di una singola macchina. Apple precisa però che non accelera necessariamente l’inferenza, perché ogni token deve comunque attraversare sequenzialmente i diversi gruppi di layer.
Con il tensor parallelism ogni Mac conserva invece una parte degli stessi layer. I nodi possono così lavorare contemporaneamente sul medesimo token.
È la strategia utilizzata di default da MLX LM e può aumentare la velocità di inferenza, ma richiede scambi molto più frequenti: la comunicazione avviene praticamente a ogni layer e per ogni token.
In questo scenario latenza e topologia dei collegamenti diventano particolarmente importanti.
Mesh o anello: con quattro Mac possono servire sei collegamenti
JACCL supporta principalmente due topologie: mesh e ring.
In una configurazione ad anello ogni Mac comunica direttamente soltanto con i due nodi vicini. Servono meno cavi e meno porte, ma per raggiungere una macchina non adiacente i dati devono attraversare un nodo intermedio, aumentando la latenza.
In una configurazione full mesh ogni Mac è invece collegato direttamente con tutti gli altri.
Con due computer basta un collegamento Thunderbolt. Con quattro Mac una mesh completa richiede sei collegamenti diretti.
Apple spiega inoltre che, quando le macchine sono collegate in mesh, JACCL può scegliere il percorso più appropriato in base al tipo di comunicazione: la mesh quando pesa soprattutto la latenza, l’anello quando conta maggiormente la banda e può essere vantaggioso aggregare più collegamenti fra nodi adiacenti.
La configurazione non è quindi soltanto una questione di quanti cavi si hanno sulla scrivania.
Avevamo già visto una configurazione reale di questo tipo nel dicembre 2025, quando quattro Mac Studio erano stati utilizzati per gestire complessivamente 1,5 TB di memoria.
RDMA arriva vicino agli 80 Gbit/s di Thunderbolt 5
Macotakara ha effettuato una prova collegando un Mac Studio 2026 con M5 Ultra e 256 GB a un Mac Studio 2025 con M4 Max e 128 GB utilizzando un cavo OWC Thunderbolt 5.
Nel trasferimento DMA con buffer da 256 MiB è stata misurata una velocità di circa 8,65 GiB/s, equivalenti a circa 74 Gbit/s.
Il valore corrisponde a circa il 93% degli 80 Gbit/s nominali del collegamento Thunderbolt 5 bidirezionale.
Questo rende più chiaro il vantaggio rispetto a una tradizionale rete IP e mostra che l’interconnessione può lavorare molto vicino al limite nominale del collegamento.
Rimane comunque una distanza enorme rispetto alla banda della memoria interna del Mac Studio. Per questo il software cerca di mantenere localmente sul singolo nodo quanti più dati possibile e di ridurre gli scambi attraverso Thunderbolt alle operazioni effettivamente necessarie.
Perché RDMA è diverso dall’IP over Thunderbolt
Thunderbolt consentiva già da tempo di creare collegamenti di rete fra Mac attraverso IP over Thunderbolt.
Questa soluzione rimane adatta ad attività come SSH, condivisione di file, NFS e protocolli di rete tradizionali.
Con un carico AI distribuito, invece, la latenza diventa molto più importante. Una comunicazione IP deve attraversare diversi livelli software e richiede un maggiore intervento della CPU; RDMA consente invece un percorso molto più diretto dalla memoria di una macchina a quella dell’altra.
Le due tecnologie possono convivere.
Apple mostra, per esempio, un MacBook che raggiunge i vari Mac Studio attraverso SSH sulla normale rete locale per avviare il lavoro. Una volta partito il processo distribuito, lo scambio più pesante fra i nodi passa direttamente sui collegamenti Thunderbolt attraverso RDMA.
Il traffico di controllo può quindi utilizzare Ethernet o Wi-Fi, mentre quello sensibile a banda e latenza viene spostato sul percorso Thunderbolt.
Meglio costruire il cluster con Mac simili
Il test di Macotakara evidenzia anche un limite pratico che diventa importante quando si progetta il cluster.
Utilizzando un Mac Studio con 256 GB e uno con 128 GB, MLX ha distribuito il modello uniformemente fra i due nodi. Nel caso provato sono quindi risultati utilizzabili 128 GB su ciascuna macchina, per un totale di circa 256 GB destinati al modello distribuito.
I 128 GB aggiuntivi presenti sul Mac più capiente non venivano sfruttati dalla stessa distribuzione.
Macotakara segnala inoltre timeout con modelli molto grandi quando i due Mac hanno prestazioni sensibilmente differenti.
Per un cluster destinato stabilmente all’AI diventa quindi preferibile utilizzare macchine simili sia per prestazioni sia per quantità di memoria.
Collegare un Mac Studio molto potente a una macchina meno dotata può essere utile per sperimentare, ma non significa automaticamente poter sommare linearmente tutta la RAM e tutta la capacità di calcolo disponibile.
Il vantaggio più interessante può essere la capacità, non la velocità
Il dato delle prestazioni quasi triplicate è immediato da comunicare, ma con i modelli più grandi il vero vantaggio del cluster può essere semplicemente riuscire a caricarli.
Apple mostra alla WWDC26 Kimi K2.6 da circa un trilione di parametri. Con una quantizzazione a 8 bit i soli pesi richiedono circa un terabyte di memoria: troppo per un singolo M3 Ultra, ma gestibile distribuendo il modello su quattro macchine.
È la stessa logica che abbiamo analizzato nel nostro approfondimento su modelli da 70B, 405B e 1T, quantizzazione, memoria unificata e RDMA.
Un modello che entra comodamente nella memoria locale di un Mac può non avere bisogno di un cluster. Quando invece i pesi, la cache e il contesto superano la capacità della singola macchina, poter distribuire il modello cambia direttamente ciò che è possibile eseguire.
L’AI locale sul Mac parte anche da configurazioni molto più semplici
Un cluster da quattro Mac Studio rappresenta l’estremo superiore di questa impostazione, ma l’AI locale sul Mac comprende anche configurazioni molto più accessibili.
Nella nostra guida all’uso di Ollama e Mistral in locale abbiamo mostrato come installare ed eseguire un modello linguistico direttamente sul computer senza affidarsi necessariamente a un servizio cloud.
L’immagine seguente è tratta dall’interno di quell’approfondimento Macitynet.

Lo stesso vale per la generazione di immagini. La nostra guida da zero a ComfyUI su Mac mostra come configurare Homebrew, Python, Metal e modelli FLUX su Apple silicon.
Questa immagine, anch’essa già utilizzata all’interno dell’articolo Macitynet, è stata generata localmente con FLUX.1 Schnell:
La quantità di memoria necessaria cambia radicalmente a seconda del modello e del compito: generazione di immagini, LLM da pochi miliardi di parametri e modelli da centinaia di miliardi o un trilione di parametri appartengono a classi di utilizzo molto diverse.
macOS 27 abbassa la barriera per i piccoli cluster AI
La novità di macOS 27 non consiste quindi nell’arrivo di RDMA, presente già da macOS 26.2.
Cambia soprattutto la facilità con cui può essere attivato.
Passare dalla modalità Recovery e da un comando del Terminale a un interruttore nelle Impostazioni di Sistema elimina uno dei passaggi più scomodi per chi vuole sperimentare con più Mac.
Con due macchine la configurazione fisica rimane relativamente semplice. Con quattro nodi entrano invece in gioco topologia, numero di porte e cavi, MLX, JACCL, configurazione SSH e scelta della strategia con cui suddividere il modello.
Non diventa quindi una funzione per tutti, ma è molto più accessibile a sviluppatori, ricercatori, studi e aziende che vogliono eseguire modelli AI molto grandi in locale evitando server GPU dedicati o infrastrutture cloud per ogni elaborazione.
Per chi sta valutando l’hardware abbiamo approfondito separatamente quanto cambia passando da 96 a 256 GB di memoria sul Mac Studio M5 Ultra e quando possono avere senso due Mac anziché uno.
Per scoprire le altre funzioni introdotte con il nuovo sistema operativo potete invece leggere il nostro approfondimento con 15 novità da provare su macOS 27. Chi deve ancora installarlo può consultare la guida su come preparare il Mac all’aggiornamento.
AI locale, Mac Studio e Thunderbolt 5: le guide Macitynet
AI sul Mac, la guida da zero: installare ComfyUI e generare immagini in locale

Il Mac e l’AI locale: memoria unificata, LLM e vantaggi di Apple silicon

Mac Studio M5 Ultra e AI: cosa significano 70B, 405B, 1T e RDMA
Mac Studio M5 Ultra 96 GB vs 256 GB: 7.000 contro 14.000 euro

Un cluster di Mac Studio per gestire 1,5 TB di memoria con Thunderbolt 5

AI fatta in casa: come iniziare con Ollama e Mistral in locale