Le fasce EEG vendute per monitorare il sonno, meditare o migliorare la concentrazione possono raccogliere migliaia di ore di attività cerebrale e, in alcuni casi, quei dati sono stati utilizzati per addestrare modelli di intelligenza artificiale senza che le informative privacy lo spiegassero chiaramente agli utenti.
Chi indossa una fascia per meditare o monitorare il sonno pensa soprattutto al risultato mostrato dall’app: un grafico con le fasi della notte, un punteggio o qualche indicazione sulla concentrazione. Dietro quei risultati ci sono però registrazioni EEG, segnali elettrici prodotti dall’attività cerebrale che possono essere conservati e riutilizzati. A ricostruire ciò che accade dopo la raccolta è un’inchiesta durata un anno, firmata dal giornalista freelance Jonathan Moens per la rivista Science.
I numeri dell’inchiesta
Il lavoro ha passato al setaccio le informative di 57 aziende che vendono dispositivi EEG consumer, cioè apparecchi che rilevano dal cuoio capelluto l’attività elettrica del cervello. Quattro aziende non avevano alcuna privacy policy e altre undici disponevano di un documento riferito soltanto ai visitatori del sito, senza spiegare che cosa accadesse ai dati EEG raccolti da dispositivo e app.
Il quadro è quindi molto disomogeneo già prima di arrivare all’intelligenza artificiale. Alcune aziende spiegano in dettaglio raccolta e utilizzo dei segnali, altre lasciano aperte questioni fondamentali come la conservazione, la condivisione con terzi e l’impiego per ricerca.
Il dato più significativo riguarda nove aziende che avevano dichiarato pubblicamente di sviluppare grandi modelli AI del cervello. All’inizio dell’indagine nessuna delle società consumer coinvolte che stava costruendo uno di questi modelli lo indicava esplicitamente nella propria informativa. Science considera inoltre quelle nove aziende una stima minima, perché altre potrebbero lavorare a tecnologie analoghe senza averlo annunciato.
Anche le clausole sulla circolazione dei dati sono ampie. Secondo l’inchiesta pubblicata da Science, tutte le aziende dotate di un’informativa tranne una consentono qualche forma di condivisione dei dati anonimizzati, aggregati o deidentificati; soltanto sei escludono esplicitamente la vendita dei dati cerebrali. Oltre due terzi prevedono inoltre il trasferimento dei dati al nuovo proprietario in caso di acquisizione o fusione dell’azienda.
Per una piccola startup neurotech questo punto ha una conseguenza molto concreta: una cessione societaria può portare nelle mani del nuovo proprietario anche l’archivio di registrazioni EEG accumulato negli anni, nei limiti previsti dall’informativa e dalla legislazione applicabile.
Cos’è un “modello fondazionale del cervello”
L’idea riprende quella dei foundation model usati nell’intelligenza artificiale. Invece di costruire da zero un algoritmo per ogni singolo compito, un modello viene prima addestrato su enormi quantità di registrazioni EEG per impararne strutture e schemi ricorrenti; successivamente può essere specializzato per riconoscere determinate condizioni o attività, come le fasi del sonno o alcuni segnali associati a crisi epilettiche.
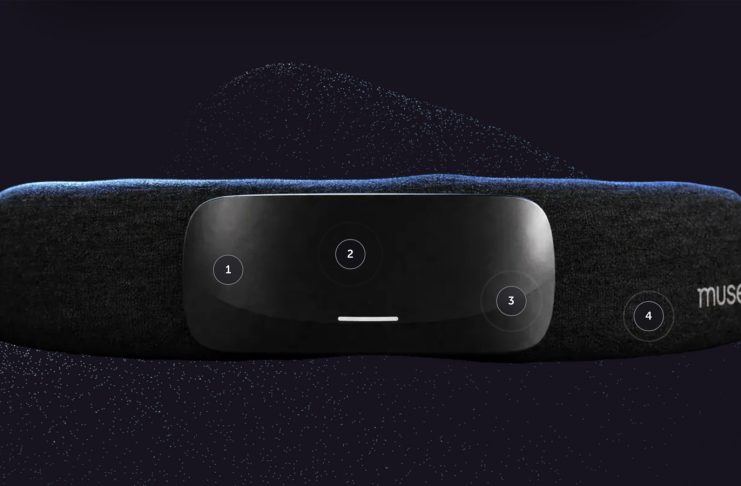
Nel caso di Interaxon, l’azienda canadese che produce le fasce Muse, l’obiettivo dichiarato è utilizzare grandi quantità di EEG per sviluppare modelli capaci di comprendere meglio schemi legati, fra le altre cose, al sonno e alla concentrazione.
Il caso Muse: 50.000 ore di EEG
Interaxon è l’azienda che ha fornito a Science uno dei dati più significativi: ha dichiarato di avere già addestrato un modello fondazionale utilizzando circa 50.000 ore di registrazioni EEG, per la maggior parte provenienti dagli utenti dei suoi dispositivi. Prima dell’impiego, secondo l’azienda, vengono rimossi identificatori diretti come nomi ed email.
Il problema emerso dall’inchiesta riguarda però ciò che veniva comunicato agli utenti. La privacy policy non spiegava esplicitamente che le registrazioni potevano servire anche ad addestrare modelli AI del cervello. Interaxon ha modificato il testo dopo le domande di Science e la responsabile marketing Nadia Kumentas ha riconosciuto che gli utenti avrebbero dovuto essere informati in maniera esplicita.
La nuova informativa chiarisce l’impiego di dati deidentificati per algoritmi e modelli di machine learning, compresi i foundation model. Restano però questioni importanti: Interaxon non ha indicato a Science quante persone siano rappresentate nelle 50.000 ore di registrazioni né se gli utenti possano escludere retroattivamente dall’addestramento dati già utilizzati.
C’è anche un problema tecnico che va oltre il semplice aggiornamento dell’informativa. Cancellare una registrazione da un archivio è relativamente semplice; rimuovere da un modello già addestrato l’influenza riconducibile ai dati di una singola persona è molto più complesso. Esiste un intero settore di ricerca, chiamato machine unlearning, dedicato proprio a questo problema, ma non equivale alla semplice cancellazione di un file.
Emotiv sceglie l’opt-in
L’altro nome di rilievo è Emotiv. L’azienda ha spiegato a Science che il suo “Large Brain Model” viene addestrato anche con dati provenienti dagli utenti dei dispositivi di fascia alta, oltre che con dataset pubblici e materiale ottenuto attraverso collaborazioni con università e aziende.
Dopo le domande del giornalista, Emotiv ha aggiornato la propria informativa specificando che i dati neurali deidentificati vengono utilizzati per addestrare il modello con il consenso esplicito opt-in dell’utente. Il confronto è utile perché mostra due possibili approcci allo stesso problema: aggiornare l’informativa generale oppure chiedere un’autorizzazione specifica prima di usare i segnali neurali per addestrare l’AI.
Niente lettura del pensiero, almeno con queste fasce
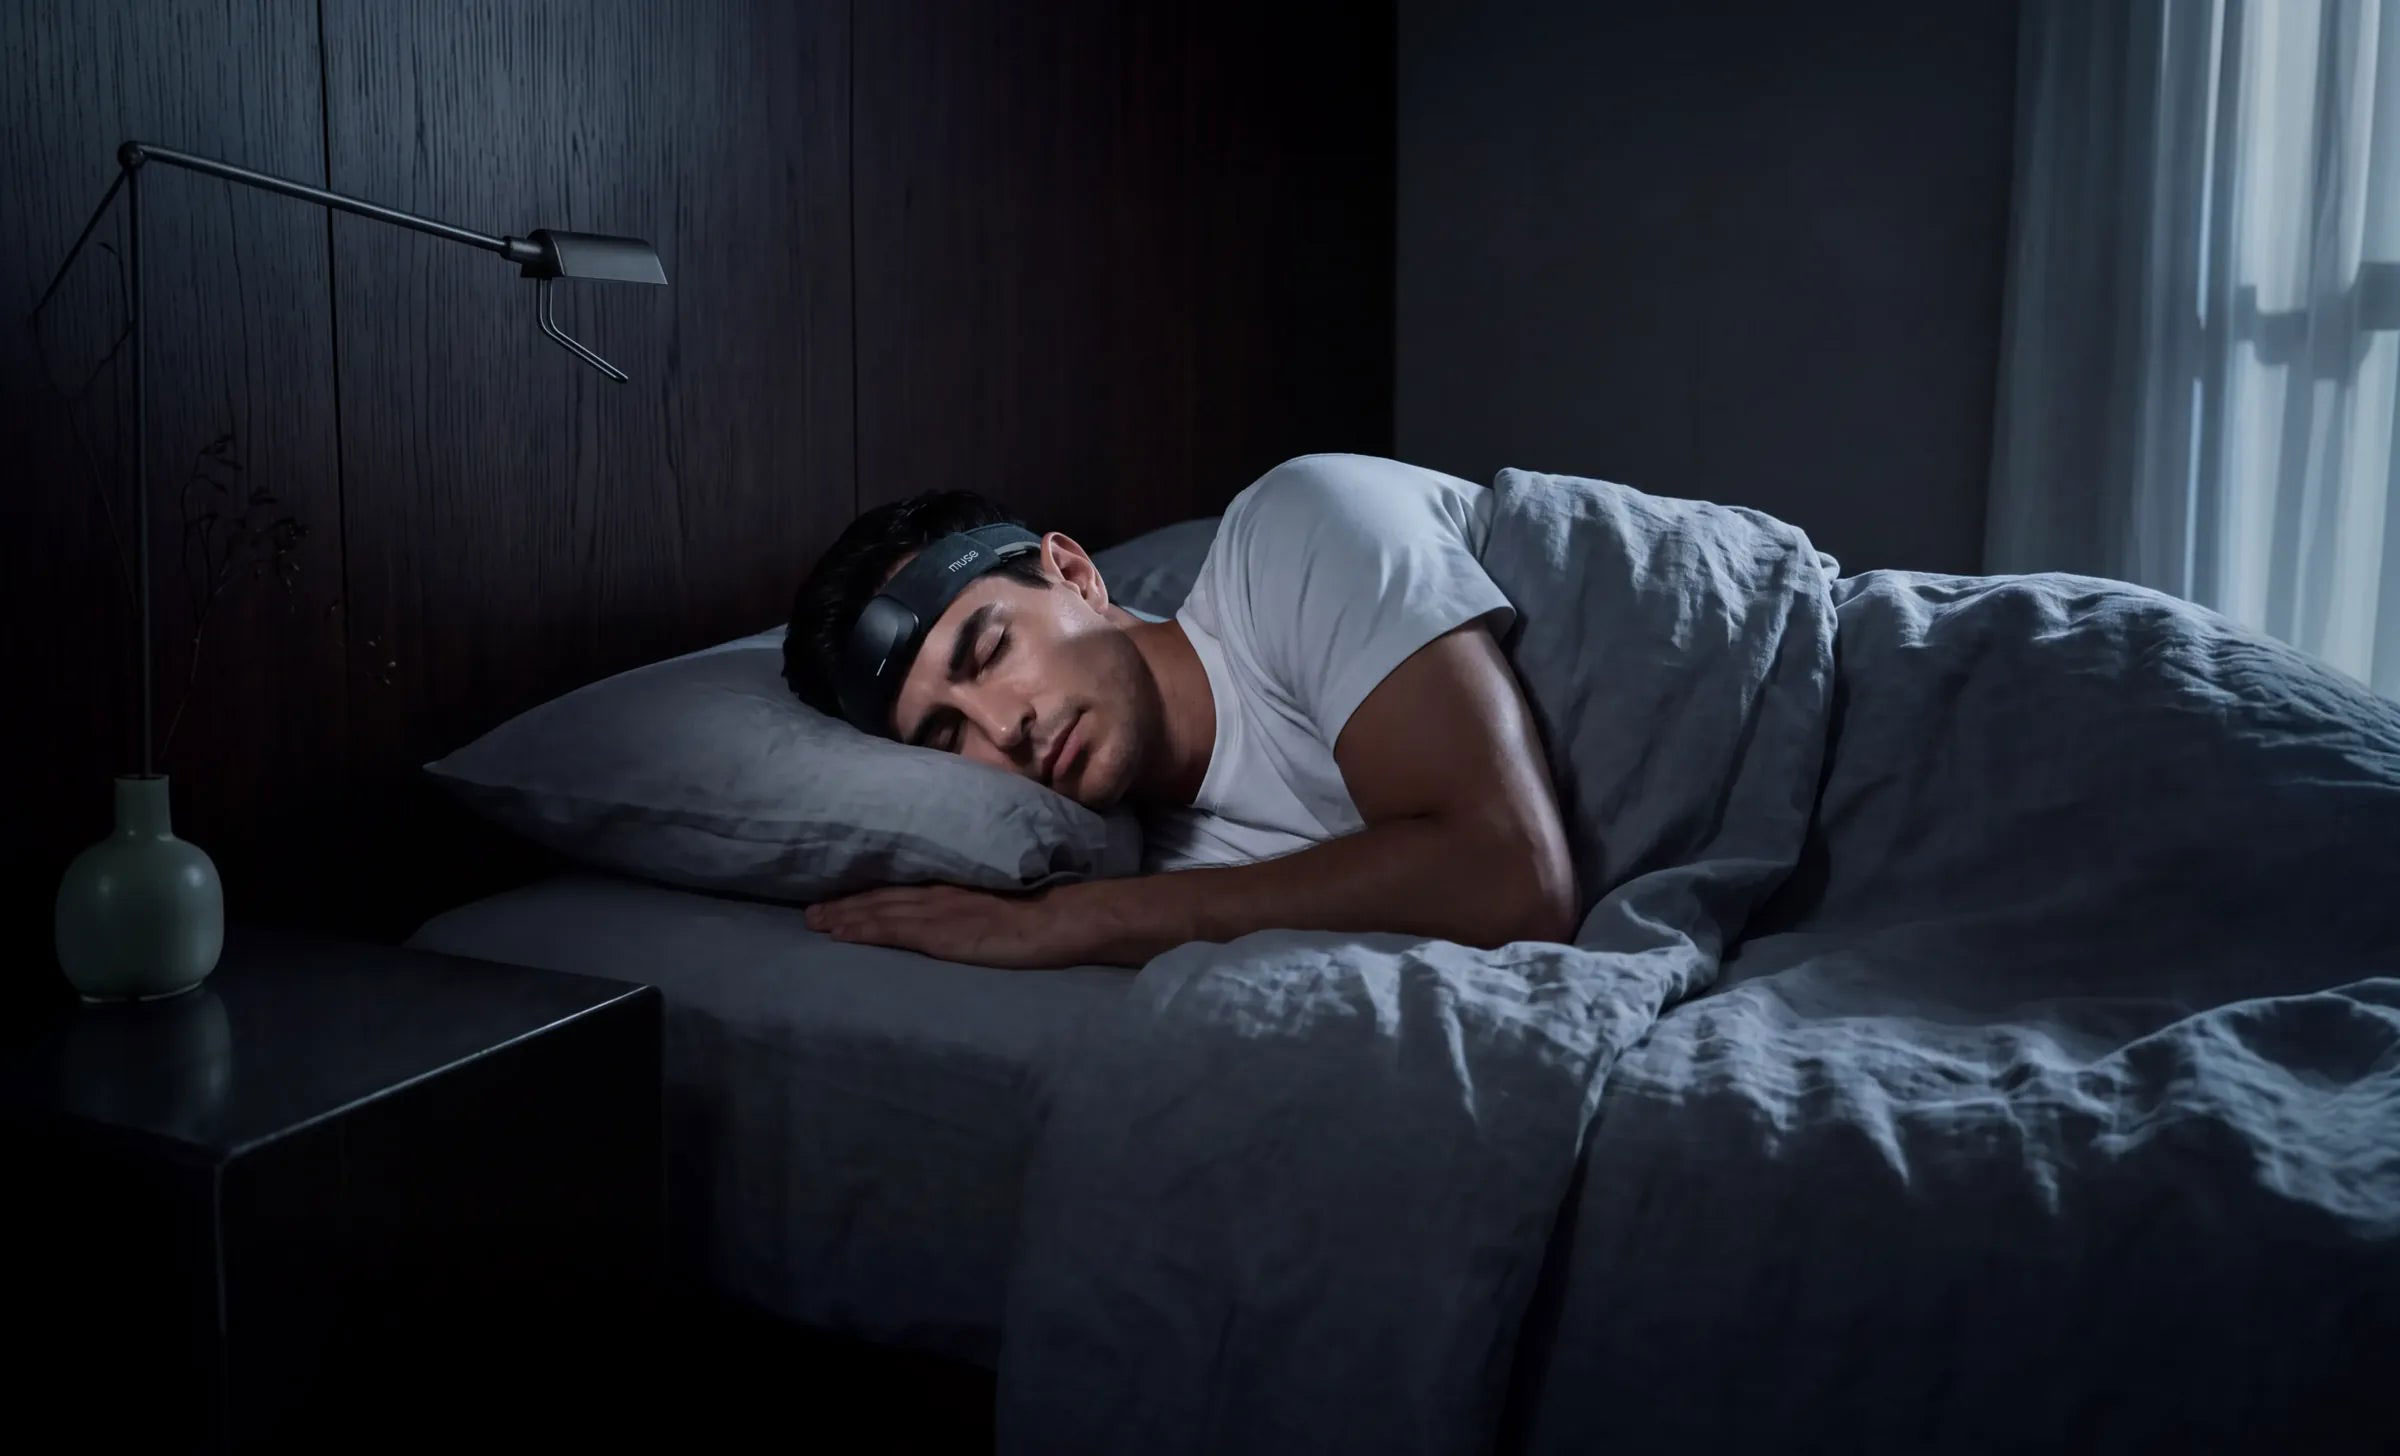
Questo non significa che una fascia EEG consumer sia in grado di tradurre liberamente ciò che una persona sta pensando. I dispositivi indossabili utilizzano pochi elettrodi rispetto ai sistemi clinici e raccolgono una rappresentazione molto più limitata dell’attività cerebrale. L’EEG è inoltre molto efficace nel seguire variazioni temporali dell’attività elettrica, ma offre una capacità di localizzazione inferiore rispetto ad altre tecniche e non permette da solo di ricostruire liberamente pensieri, ricordi o intenzioni.
Il settore della neurotecnologia sta comunque avanzando rapidamente. Su Macitynet abbiamo approfondito le tecnologie che tentano di interpretare l’attività cerebrale con l’intelligenza artificiale, dai sistemi sperimentali alle applicazioni mediche, e il relativo dibattito sui cosiddetti neurodiritti.
La questione posta dall’inchiesta di Science è quindi più immediata: indipendentemente da ciò che oggi sia possibile dedurre da una registrazione EEG consumer, chi produce quei dati dovrebbe sapere per quali finalità vengono conservati e utilizzati.
La strada alternativa: dati clinici con provenienza chiara
I dati raccolti dai dispositivi consumer non sono l’unica strada per costruire questi modelli. La startup Piramidal dichiara di avere preaddestrato il proprio modello fondazionale su oltre 4 milioni di ore di EEG, utilizzando dataset pubblici e collaborazioni con strutture e istituzioni sanitarie.
Una collaborazione con Cleveland Clinic mostra l’approccio in ambito clinico. Il modello, inizialmente addestrato su grandi raccolte pubbliche di EEG, è stato successivamente rifinito utilizzando registrazioni accuratamente annotate dalla Cleveland Clinic e poi sottoposto a una sperimentazione pilota retrospettiva.
Nel rilevamento e nella localizzazione delle crisi epilettiche il sistema ha ottenuto circa il 90% di sensibilità e il 90% di specificità: nove crisi su dieci sono state individuate correttamente e nove segnalazioni su dieci corrispondevano effettivamente a una crisi. Sono risultati preliminari e riferiti a quello specifico compito, ma mostrano che la costruzione di grandi modelli EEG non richiede necessariamente di attingere alle registrazioni raccolte dai dispositivi consumer.
Il nodo normativo negli Stati Uniti
A livello federale gli Stati Uniti non dispongono ancora di una disciplina generale specificamente dedicata ai neurodati consumer. Il MIND Act of 2025, S.2925, presentato al Senato il 29 settembre 2025, propone di incaricare la Federal Trade Commission di studiare la governance dei dati neurali e delle informazioni correlate e di riferire al Congresso.
Nel frattempo si stanno muovendo i singoli Stati. Il Colorado ha incluso i dati neurali tra quelli soggetti a maggiori tutele nella propria legislazione sulla privacy. Dal 2025 il Montana tutela espressamente i “neurotechnology data” nel Genetic Information Privacy Act, introducendo obblighi su informativa, consenso, accesso, cancellazione e conservazione.
Dal 1° luglio 2026 anche il Connecticut include esplicitamente i neural data tra i dati sensibili coperti dal Connecticut Data Privacy Act. La California si era mossa prima: dal 1° gennaio 2025 il CCPA considera i dati neurali una forma di sensitive personal information, dando agli utenti anche il diritto di limitarne determinati utilizzi.
Il precedente del Cile
Il Cile si è mosso ancora prima sul terreno dei neurodiritti. Nel 2021 ha modificato la Costituzione introducendo una tutela specifica dell’attività cerebrale e delle informazioni che ne derivano nell’ambito dello sviluppo scientifico e tecnologico.
Il 9 agosto 2023 la Corte Suprema cilena ha inoltre accolto il ricorso dell’ex senatore Guido Girardi contro Emotiv. La Corte ha ritenuto che la commercializzazione del dispositivo Insight e la conservazione dei dati sull’attività elettrica cerebrale coinvolgessero i diritti alla privacy e all’integrità fisica e psichica e ha ordinato la cancellazione delle informazioni conservate in relazione all’uso del dispositivo da parte di Girardi.
E in Europa?
Il GDPR non contiene una categoria autonoma chiamata “neurodati”, ma questo non significa che le registrazioni EEG rimangano fuori dalla normativa europea. L’European Data Protection Supervisor osserva che i neurodati riferiti a una persona sono dati personali e che, in molti casi, possono rientrare anche nelle categorie particolari previste dalla normativa, per esempio come dati biometrici o relativi alla salute.
Nel suo TechDispatch dedicato ai neurodati, l’EDPS richiama inoltre principi come trasparenza, proporzionalità, correttezza e minimizzazione dei dati. Il problema è particolarmente delicato perché dai segnali neurali potrebbero diventare ricavabili informazioni ulteriori man mano che migliorano gli strumenti di analisi.
Resta poi la questione già incontrata nel caso Muse: il diritto alla cancellazione è relativamente semplice da applicare a una registrazione conservata in un database, molto meno quando quei dati hanno contribuito all’addestramento di un modello. È un problema che riguarda più in generale l’intero settore del machine learning e sul quale tecnologia e norme stanno ancora cercando soluzioni praticabili.
Non solo privacy: anche sicurezza
C’è infine il tema della sicurezza informatica, spesso meno visibile delle informative privacy. Nel febbraio 2026 l’ingegnere Aimilios Hatzistamou ha analizzato l’app di una maschera per il sonno dotata di EEG acquistata attraverso Kickstarter e ha trovato nel codice credenziali di accesso memorizzate in chiaro e apparentemente comuni a tutte le installazioni.
Utilizzandole sul server MQTT del produttore, Hatzistamou ha rilevato circa 25 maschere collegate e ha potuto ricevere in tempo reale registrazioni EEG appartenenti a due utenti sconosciuti. La scoperta è particolarmente delicata perché il dispositivo integra anche una funzione di stimolazione elettrica muscolare.
Secondo l’analisi del ricercatore, le stesse credenziali avrebbero potuto consentire anche l’invio di comandi alla funzione di stimolazione di altri dispositivi. Si tratta di una possibilità tecnica individuata durante l’analisi e non della prova che impulsi siano stati effettivamente inviati a utenti terzi, ma il caso mostra quanto sicurezza del software e privacy dei dati neurali siano due aspetti dello stesso problema.
Cosa controllare prima di acquistare una fascia EEG
Le onde cerebrali stanno diventando materiale utile per addestrare nuovi sistemi di intelligenza artificiale, così come in precedenza lo sono diventati testo, immagini e audio